ElevenLabs v4を日本語で検証。v3と聞き比べて分かった4つの違い
ElevenLabs v4を日本語で検証。v3と聞き比べて分かった4つの違い
先に結論
ElevenLabsの新しい読み上げモデル「Eleven v4」を日本語で試し、前モデルのv3と同じ台本・同じ声で聞き比べました。分かったことは4つです。
固有名詞の読み間違いは、v3の4か所からv4では2か所に減りました。ただし、難読の名字と京都の地名の一部はv4でも外しました。
オーディオタグは、v4のほうが指示どおりに演じます。ささやきは実際に声を落とします。一方でリアクションは強めで、アニメ調に聞こえました。
「安定性」のスライダーを上げても、タグ付き台本の演技の強さはほとんど変わりませんでした。
2人の掛け合いは、v4だと人間同士の会話に聞こえました。v3は淡々としています。
「v4なら何でも正しく読める」わけではありませんが、感情表現と掛け合いははっきり良くなっています。以下、使った台本と結果をそのまま載せます。
Eleven v4とは、今回の検証条件
Eleven v4は、ElevenLabsが2026年9月28日に公開したテキスト読み上げモデルです。低遅延版のEleven v4 Turboも同時に公開されました(公式ブログ)。
今回は、ElevenLabsの「テキスト読み上げ」画面で、次の条件で試しました。
項目 | 内容 |
|---|---|
比較したモデル | Eleven v3 と Eleven v4 |
声 | Akane(掛け合いではRikuを追加) |
台本 | 両モデルで同じ文を使用 |
設定 | 初期設定のまま。「自動タグ付け」は使わない |
テイク数 | 読み間違いの検証は各モデル2テイク |
声は1種類、テイク数も少ない検証です。別の声や別の台本では、違う結果になる可能性があります。

検証1:固有名詞の読み間違い
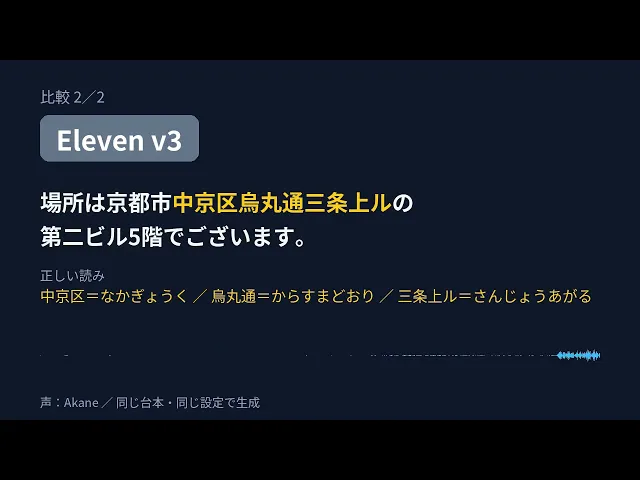
固有名詞の読み間違いは、v3の4か所からv4では2か所に減りました。人名や京都の地名など、読み間違いが起きやすい語を入れた電話応対の台本を読ませています。
語(正しい読み) | v3 | v4 |
|---|---|---|
御手洗(みたらい) | ✗ みてあらい/おてあらい | ✓ |
烏丸通(からすまどおり) | ✗ カラスマルドオリ | ✓ |
中京区(なかぎょうく) | ✗ チュウキョウク | ✓ |
三条上ル(さんじょうあがる) | ✗ サンジョウアミル | ✗ ジョウル/ウエル |
東海林(しょうじ) | △ トウカイリン | ✗ トウカイビチ |
「東海林」は「とうかいりん」と読む名字も実在するので、v3の読みは間違いとは数えていません。v4はどちらでもない「トウカイビチ」と読んだため、この語だけはv3より悪い結果です。
金額、日時、電話番号などの数字は、v4では問題なく読めていました。聞いた直後の感想は「そこ以外は完璧」です。
人名や地名を読ませる用途では、v4でも公開前に一度聞いて確認する必要があります。
検証2:オーディオタグの効き具合
オーディオタグは、v4のほうが指示どおりに演じました。ただしリアクションは強めです。オーディオタグとは、台本に [whispers] のような指示を書き込んで、声の演技を指定する機能です。
[cheerful] お電話ありがとうございます!山城商事でございます。
[apologetic] 大変申し訳ございません。ただいま担当者が席を外しております。
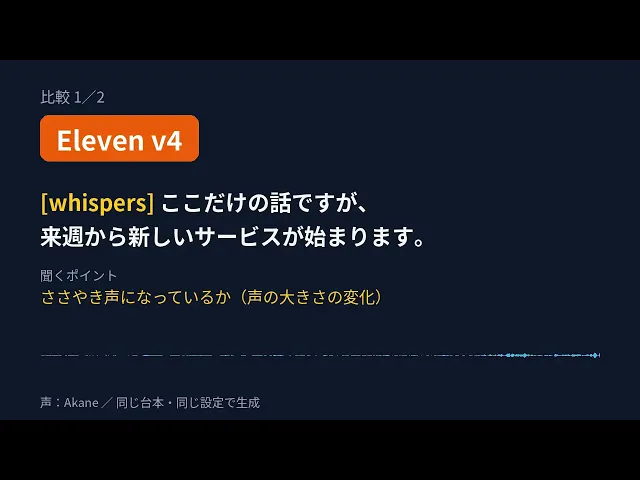
[whispers] ここだけの話ですが、来週から新しいサービスが始まります。
[laughs] いえいえ、とんでもないです。
[sighs]
見たところ | v3 | v4 |
|---|---|---|
全体の印象 | 自然に聞こえる | よくできているが、リアクションが強め |
ささやき(3行目) | 音量は他の行と同じに聞こえる | 実際にささやかれているように聞こえる |
ため息(5行目) | ため息のあと、幸せそうに話す | 気になる点なし |
聞きながら出た感想を、そのまま載せます。
v4について:「すごくよくできている」「アニメのようにリアクションが強めに感じる」
v3について:「自然のように聞こえますが、最後のため息の後、何だか幸せそうに喋っていたりしています」
ささやきについて:「v3はボリュームが同じように聞こえるのに加えて、v4は実際囁かれてるような感じだった」
v3はタグの直後だけ演技して、続く文に感情が引き継がれない場面がありました。v4では、そうした違和感はありませんでした。動画やキャラクターの声には向きますが、電話応対のような落ち着いた読み上げには、初期設定のままだと演技が濃く感じます。
検証3:安定性スライダーで演技を抑えられるか
抑えられませんでした。v4のリアクションの強さを落ち着かせたくて、設定の「安定性」を右いっぱい(安定寄り)にして、検証2と同じ台本を生成し直しました。
聞いた感想は「あんまり差を感じない」です。タグを付けた台本では、スライダーよりもタグの指示のほうが強く効いているようです。
落ち着いた読み上げにしたい場合は、スライダーで調整するより、タグを外すほうが確実だと考えられます。ただし、タグを外した台本での比較は今回行っていないので、ここは推測です。
検証4:2人の掛け合い
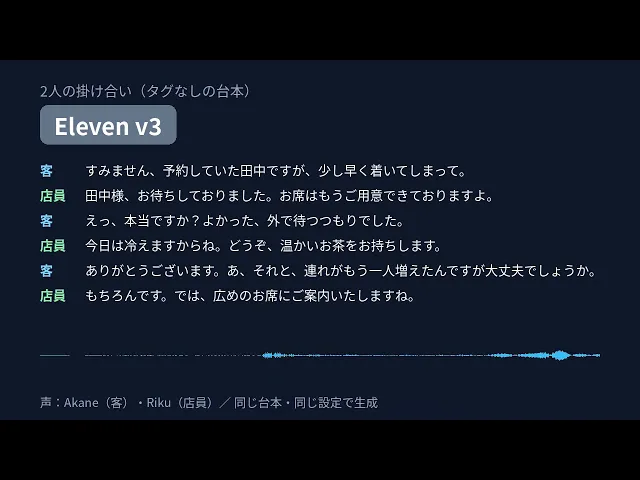
掛け合いは、v4だと人間同士の会話に聞こえました。入力欄の「スピーカーを追加」で、客(Akane)と店員(Riku)の会話を作っています。タグはあえて入れず、文脈だけで演じ分けるかを見ました。
聞いた感想は次のとおりです。
v4:「しっかり会話に聞こえます。感情ものっているし、実際に人間同士が会話しているようです」
v3:「感情の乗り具合が違いますね。実際の人間でこんなふうに感情が乗っていない人もいますが」
v3が不自然というわけではありません。v3は淡々と話す人同士の会話、v4は感情を込めて話す人同士の会話に聞こえる、という差です。
ElevenLabsは、v4が場面全体の文脈を理解して、直前の発言に反応するような対話を作ると説明しています(公式ブログ)。今回の結果は、その説明と合っていました。

注意点:v4は「話す」モデルで、「聞く」性能は別
Eleven v4で良くなるのは声を作る部分だけで、聞き取りの精度は変わりません。検証を始める前は、音声エージェントの聞き間違いや雑音への強さも良くなるのかと期待していましたが、そこは別の部品の担当でした。
ElevenLabsの音声エージェントは、3つの部品をつないで動いています。
聞く:音声認識が、相手の声を文字にする
考える:LLMが、文字になった内容を読んで返答を作る
話す:読み上げモデルが、返答を声にする(v4とv4 Turboはここ)
名前の聞き間違いや雑音への反応は1番目の問題です。電話応対のような用途でv4 Turboに切り替えても、期待できるのは声の自然さと、話し始めるまでの速さです。
まとめ
Eleven v4は、v3と比べて読みの正確さ、タグへの追従、掛け合いの自然さが良くなっていました。用途ごとに整理すると、次のようになります。
用途 | v4の向き・不向き |
|---|---|
動画のナレーション、キャラクターの声 | 向いている。タグで感情を指定でき、ささやきなども表現できる |
2人以上の会話音声 | 向いている。タグなしでも会話として聞こえる |
人名・地名を含む案内音声 | 改善したが、難読の語は外す。公開前に聞いて確認する |
落ち着いた電話応対の読み上げ | タグを付けると演技が濃い。タグの使い方に注意が要る |
今回試せていないこともあります。長文での声の一貫性、別の声での再確認、v4 Turboを音声エージェントに組み込んだときの速さは未検証です。
先に結論
ElevenLabsの新しい読み上げモデル「Eleven v4」を日本語で試し、前モデルのv3と同じ台本・同じ声で聞き比べました。分かったことは4つです。
固有名詞の読み間違いは、v3の4か所からv4では2か所に減りました。ただし、難読の名字と京都の地名の一部はv4でも外しました。
オーディオタグは、v4のほうが指示どおりに演じます。ささやきは実際に声を落とします。一方でリアクションは強めで、アニメ調に聞こえました。
「安定性」のスライダーを上げても、タグ付き台本の演技の強さはほとんど変わりませんでした。
2人の掛け合いは、v4だと人間同士の会話に聞こえました。v3は淡々としています。
「v4なら何でも正しく読める」わけではありませんが、感情表現と掛け合いははっきり良くなっています。以下、使った台本と結果をそのまま載せます。
Eleven v4とは、今回の検証条件
Eleven v4は、ElevenLabsが2026年9月28日に公開したテキスト読み上げモデルです。低遅延版のEleven v4 Turboも同時に公開されました(公式ブログ)。
今回は、ElevenLabsの「テキスト読み上げ」画面で、次の条件で試しました。
項目 | 内容 |
|---|---|
比較したモデル | Eleven v3 と Eleven v4 |
声 | Akane(掛け合いではRikuを追加) |
台本 | 両モデルで同じ文を使用 |
設定 | 初期設定のまま。「自動タグ付け」は使わない |
テイク数 | 読み間違いの検証は各モデル2テイク |
声は1種類、テイク数も少ない検証です。別の声や別の台本では、違う結果になる可能性があります。
検証1:固有名詞の読み間違い
固有名詞の読み間違いは、v3の4か所からv4では2か所に減りました。人名や京都の地名など、読み間違いが起きやすい語を入れた電話応対の台本を読ませています。
語(正しい読み) | v3 | v4 |
|---|---|---|
御手洗(みたらい) | ✗ みてあらい/おてあらい | ✓ |
烏丸通(からすまどおり) | ✗ カラスマルドオリ | ✓ |
中京区(なかぎょうく) | ✗ チュウキョウク | ✓ |
三条上ル(さんじょうあがる) | ✗ サンジョウアミル | ✗ ジョウル/ウエル |
東海林(しょうじ) | △ トウカイリン | ✗ トウカイビチ |
「東海林」は「とうかいりん」と読む名字も実在するので、v3の読みは間違いとは数えていません。v4はどちらでもない「トウカイビチ」と読んだため、この語だけはv3より悪い結果です。
金額、日時、電話番号などの数字は、v4では問題なく読めていました。聞いた直後の感想は「そこ以外は完璧」です。
人名や地名を読ませる用途では、v4でも公開前に一度聞いて確認する必要があります。
検証2:オーディオタグの効き具合
オーディオタグは、v4のほうが指示どおりに演じました。ただしリアクションは強めです。オーディオタグとは、台本に [whispers] のような指示を書き込んで、声の演技を指定する機能です。
[cheerful] お電話ありがとうございます!山城商事でございます。
[apologetic] 大変申し訳ございません。ただいま担当者が席を外しております。
[whispers] ここだけの話ですが、来週から新しいサービスが始まります。
[laughs] いえいえ、とんでもないです。
[sighs]
見たところ | v3 | v4 |
|---|---|---|
全体の印象 | 自然に聞こえる | よくできているが、リアクションが強め |
ささやき(3行目) | 音量は他の行と同じに聞こえる | 実際にささやかれているように聞こえる |
ため息(5行目) | ため息のあと、幸せそうに話す | 気になる点なし |
聞きながら出た感想を、そのまま載せます。
v4について:「すごくよくできている」「アニメのようにリアクションが強めに感じる」
v3について:「自然のように聞こえますが、最後のため息の後、何だか幸せそうに喋っていたりしています」
ささやきについて:「v3はボリュームが同じように聞こえるのに加えて、v4は実際囁かれてるような感じだった」
v3はタグの直後だけ演技して、続く文に感情が引き継がれない場面がありました。v4では、そうした違和感はありませんでした。動画やキャラクターの声には向きますが、電話応対のような落ち着いた読み上げには、初期設定のままだと演技が濃く感じます。
検証3:安定性スライダーで演技を抑えられるか
抑えられませんでした。v4のリアクションの強さを落ち着かせたくて、設定の「安定性」を右いっぱい(安定寄り)にして、検証2と同じ台本を生成し直しました。
聞いた感想は「あんまり差を感じない」です。タグを付けた台本では、スライダーよりもタグの指示のほうが強く効いているようです。
落ち着いた読み上げにしたい場合は、スライダーで調整するより、タグを外すほうが確実だと考えられます。ただし、タグを外した台本での比較は今回行っていないので、ここは推測です。
検証4:2人の掛け合い
掛け合いは、v4だと人間同士の会話に聞こえました。入力欄の「スピーカーを追加」で、客(Akane)と店員(Riku)の会話を作っています。タグはあえて入れず、文脈だけで演じ分けるかを見ました。
聞いた感想は次のとおりです。
v4:「しっかり会話に聞こえます。感情ものっているし、実際に人間同士が会話しているようです」
v3:「感情の乗り具合が違いますね。実際の人間でこんなふうに感情が乗っていない人もいますが」
v3が不自然というわけではありません。v3は淡々と話す人同士の会話、v4は感情を込めて話す人同士の会話に聞こえる、という差です。
ElevenLabsは、v4が場面全体の文脈を理解して、直前の発言に反応するような対話を作ると説明しています(公式ブログ)。今回の結果は、その説明と合っていました。
注意点:v4は「話す」モデルで、「聞く」性能は別
Eleven v4で良くなるのは声を作る部分だけで、聞き取りの精度は変わりません。検証を始める前は、音声エージェントの聞き間違いや雑音への強さも良くなるのかと期待していましたが、そこは別の部品の担当でした。
ElevenLabsの音声エージェントは、3つの部品をつないで動いています。
聞く:音声認識が、相手の声を文字にする
考える:LLMが、文字になった内容を読んで返答を作る
話す:読み上げモデルが、返答を声にする(v4とv4 Turboはここ)
名前の聞き間違いや雑音への反応は1番目の問題です。電話応対のような用途でv4 Turboに切り替えても、期待できるのは声の自然さと、話し始めるまでの速さです。
まとめ
Eleven v4は、v3と比べて読みの正確さ、タグへの追従、掛け合いの自然さが良くなっていました。用途ごとに整理すると、次のようになります。
用途 | v4の向き・不向き |
|---|---|
動画のナレーション、キャラクターの声 | 向いている。タグで感情を指定でき、ささやきなども表現できる |
2人以上の会話音声 | 向いている。タグなしでも会話として聞こえる |
人名・地名を含む案内音声 | 改善したが、難読の語は外す。公開前に聞いて確認する |
落ち着いた電話応対の読み上げ | タグを付けると演技が濃い。タグの使い方に注意が要る |
今回試せていないこともあります。長文での声の一貫性、別の声での再確認、v4 Turboを音声エージェントに組み込んだときの速さは未検証です。

AI・システム開発のこと、VISKにご相談ください
「自社の業務にAIを活かせないか」「この作業、自動化できないか」——
そんな漠然とした段階からで大丈夫です。大阪のAI・システム開発会社VISKが、御社の課題に合わせて、企画から開発・検証までサポートします。